
MT5 EA最適化の遺伝アルゴリズム入門
目次
MT5 EA最適化の遺伝アルゴリズム入門
EAのパラメータをチューニングするとき、MT5のストラテジーテスターには2種類の最適化モードがあります。「総当たり(全パラメータの組み合わせを全部試す)」と「遺伝アルゴリズム(GA)」です。
膨大な組み合わせを現実的な時間で探索するには、遺伝アルゴリズムを使うのが標準的です。この記事では、遺伝アルゴリズム最適化の基本と、実用上のポイントを整理します。
この記事の要点
- 組み合わせが数万通りを超えるなら、総当たりではなく遺伝アルゴリズム(GA)で探索する
- 評価指標は回収係数かシャープレシオを選び、取引数の少ない解は除外する
- 最高スコアの1件ではなく、上位10〜20件のまとまり・パラメータ感度・期間分割の検証で採用値を決める
最適化の流れ(全体像)
| 手順 | やること | 詳しい解説 |
|---|---|---|
| 1 | 最適化するパラメータをロジックの核になる少数に絞る | 最適化対象は絞り込む |
| 2 | 組み合わせ数を見て、総当たりかGAかを決める | 総当たりとの使い分け |
| 3 | テスターで「遺伝的アルゴリズムに基づく高速」と評価指標を設定する | ストラテジーテスターでの設定 |
| 4 | 最適化を実行し、「最適化結果」タブで収束の様子を確認する | 遺伝アルゴリズム最適化の実行 |
| 5 | 期間分割・上位解の比較・感度チェックで過剰最適化を除く | 過剰最適化を避ける |
| 6 | 時間がかかる場合は並列エージェントやクラウドで短縮する | 並列最適化の活用 |
遺伝アルゴリズムとは
遺伝アルゴリズム(Genetic Algorithm: GA)は、生物の進化を模した最適化手法です。具体的には次のような流れで進みます。
- ランダムなパラメータの組(個体)を複数生成
- 各個体でバックテストを実行し、評価指標(PF、回収係数など)でスコアリング
- 上位の個体を「親」として選び、交叉・突然変異で次世代を生成
- これを繰り返し、世代を重ねるほど評価が高いパラメータに収束
総当たりが「全ての組み合わせを総なめ」するのに対し、GAは「良さそうな領域に絞って探索」するため、計算時間が桁違いに短くなります。
総当たりとの使い分け
| 総当たり | 遺伝アルゴリズム(GA) | |
|---|---|---|
| 探索の仕方 | 全ての組み合わせを総なめ | 良さそうな領域に絞って探索 |
| 向いている規模 | パラメータ数が少なく、組み合わせが数千以下 | パラメータ数が多く、組み合わせが数万以上 |
| 計算時間 | 組み合わせ数に比例して増える | 桁違いに短い |
たとえば、3つのパラメータをそれぞれ10ステップで動かすなら1,000通りなので総当たりで十分です。一方、5つのパラメータを20ステップで動かすと320万通りになり、現実的には遺伝アルゴリズムが必要になります。
ストラテジーテスターでの設定
最適化を有効にするには、ストラテジーテスター画面で以下を設定します。
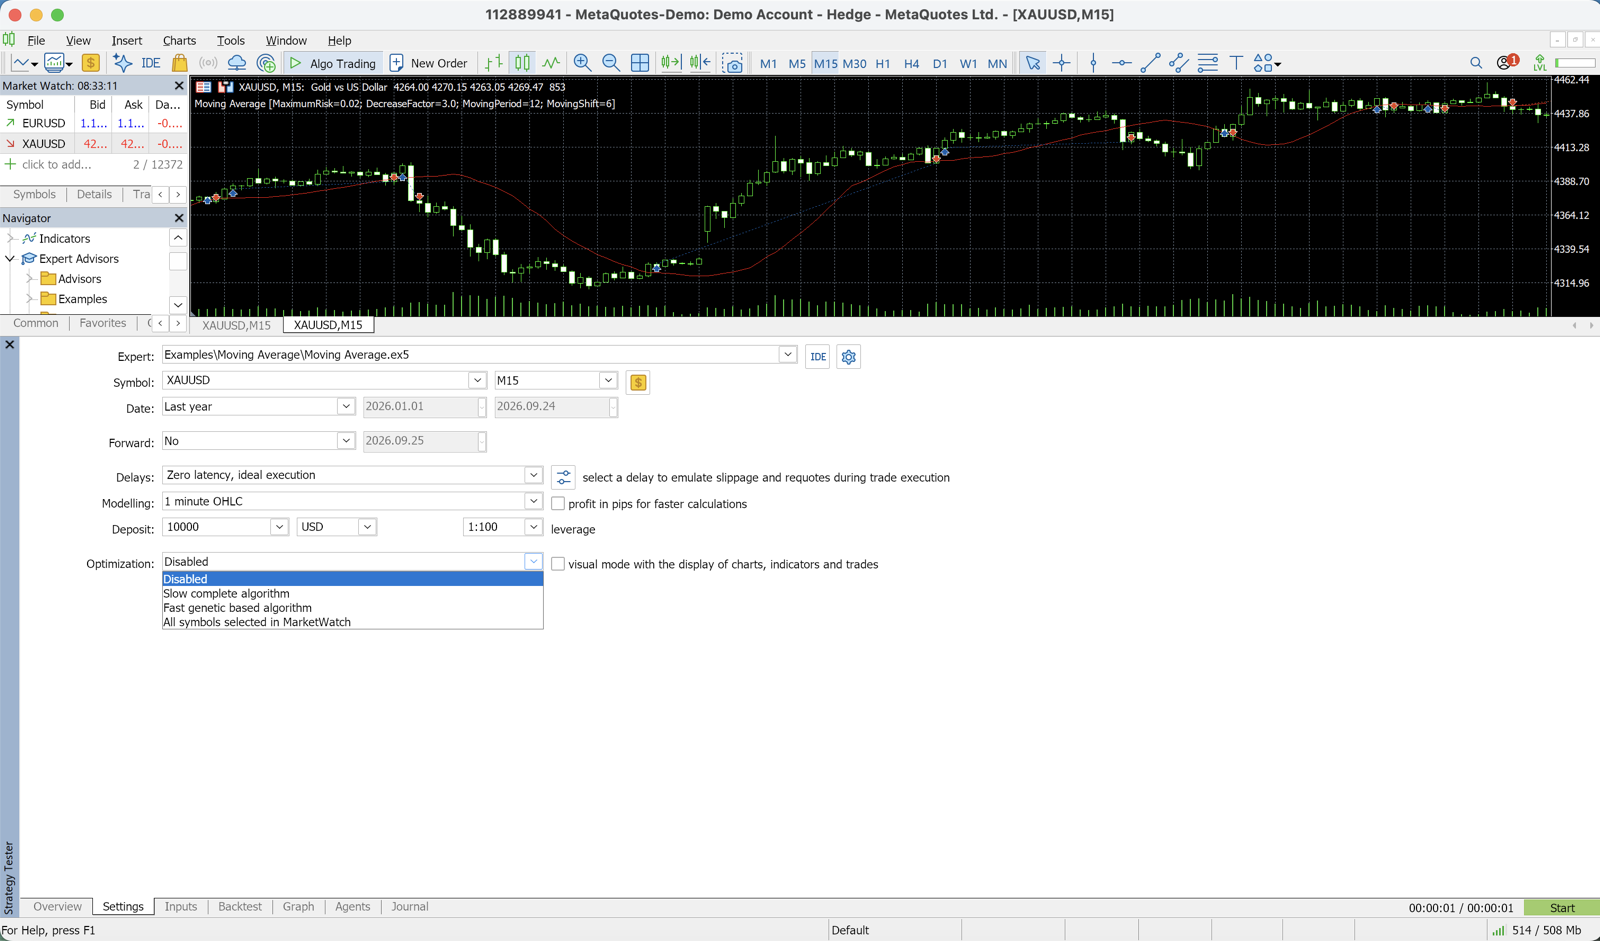
- 最適化: 「遺伝的アルゴリズムに基づく高速」を選択
- 結果: 「最大複利」「カスタム最大値」「最大回収係数」など、評価指標を選択
- 入力パラメータタブ: 最適化したいパラメータにチェック、開始値・終了値・ステップを設定
評価指標の選び方
何を「良い」とするかで結果が変わります。代表的な指標と特徴は以下です。
| 指標 | 中身 | 特徴 |
|---|---|---|
| 最大複利(プロフィット) | 利益のみを最大化 | リスクを無視するため過剰最適化に陥りやすい |
| 回収係数 | 純利益 ÷ 最大ドローダウン | バランス重視 |
| シャープレシオ | リターンの安定性を考慮 | 安定性重視 |
| カスタム最大値 | EAコード内で自由に定義可能(例: PF × 取引数) | 目的に合わせて設計できる |
回収係数またはシャープレシオを使うのが、過剰最適化を避けつつ実用的なパラメータを見つけやすい方法です。
遺伝アルゴリズム最適化の実行
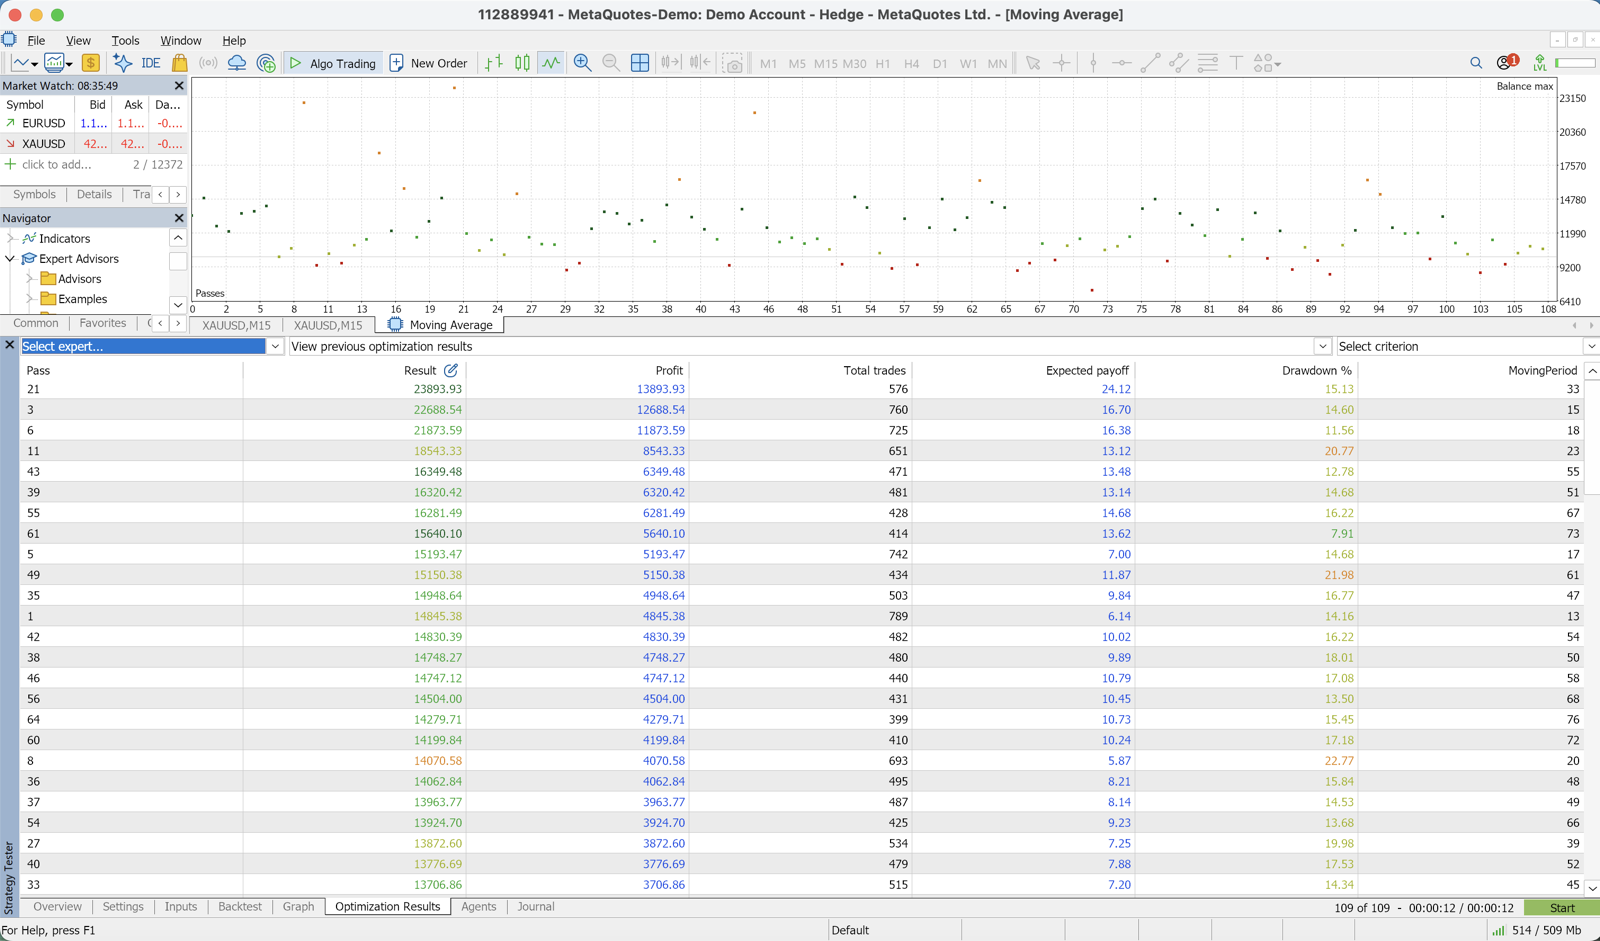
最適化を開始すると、世代ごとに評価値の高いパラメータが「最適化結果」タブに並びます。
MT5の遺伝アルゴリズムは数百世代を自動で回し、上位の解に収束していきます。
よくある落とし穴
| 症状 | 考えられる原因 |
|---|---|
| 収束が早すぎる | パラメータの探索範囲が狭すぎる可能性 |
| 全然収束しない | 評価指標が不適切、もしくはノイズが多すぎる |
| 明らかに変な値に収束する | 取引数が少なすぎる解を除外していない |
「取引数50回以下の結果は除外」といったフィルタを評価関数に組み込むことで、サンプル数の少ないノイズ解を排除できます。
過剰最適化を避ける
最適化を回せば回すほど「過去には完璧だが未来では機能しない」パラメータに近づきます。これを避けるための実践的なルールは次の4つです。
| ルール | 確認すること |
|---|---|
| 1. 期間を分割する | 後半のアウトオブサンプルで結果が崩れないか |
| 2. 上位10〜20件を比較する | 上位の解が似た領域に固まっているか |
| 3. パラメータ感度を確認 | ±10〜20%動かしても結果が大きく崩れないか |
| 4. 最適化しないパラメータも持つ | ロジック上自然な固定値を残しているか |
1. 期間を分割する
過去10年データの場合、前半7年で最適化し、後半3年でアウトオブサンプル検証します。後半で結果が崩れるなら、前半に過剰適合していたと判断できます。
2. 上位10〜20件を比較する
最高スコアの1つだけを採用するのは危険です。
上位の解が似た領域に固まっているかを確認し、固まっていればその中央付近のパラメータを採用します。
3. パラメータ感度を確認
採用候補のパラメータを±10〜20%動かして、結果が大きく崩れないかチェックします。崩れるなら、その解は「尖った最適点」に過剰適合しています。
4. 最適化しないパラメータも持つ
「最適化していない、ロジック上自然な固定値」を必ず残すことで、過剰最適化のリスクを下げられます。
たとえばEMA期間を最適化しても、ATR倍率は固定にする、など。
並列最適化の活用
MT5は複数CPUコアを使った並列最適化に対応しています。「テスター」→「設定」で使用エージェント数を増やすと、計算時間を短縮できます。
さらにMQL5クラウドネットワークを使えば、世界中のリモートエージェントを使って大規模最適化を回せますが、料金がかかるため、まずはローカルでパラメータ範囲を絞り込むのが効率的です。
最適化対象は絞り込む
最適化するパラメータは、エントリー判定の期間や損切り幅など、ロジックの核になる少数に絞るのが基本です。
それ以外のパラメータは「自然な値」に固定すると、過剰最適化を防ぎやすくなります。
バックテストのPFは最適化を回せばいくらでも上がりますが、その分だけ未来の相場で機能しなくなる可能性も上がります。**「平凡な数字を選んで長く動かす」**のが運用上の現実解です。
無料EAダウンロード
当サイトの無料EA DONCHIAN ENGINE(USDJPY H1)は、USDJPY H1・9.4年(2017-2026 Dukascopy実tick)のバックテストでPF 1.50、勝率34.5%、最大DD 10.8%、取引数631回です。
おすすめブローカー
バックテスト・最適化の結果が実運用で再現されやすいよう、当サイトでは約定品質を重視したブローカーを推奨しています。
関連記事
📧 値上げ前のお知らせ + 5日間メール講座(無料)
全EAは現在ローンチ価格で、販売数に応じて段階的に値上げされます。値上げ前の事前通知に加えて、FX自動売買の本質、バックテストの正しい見方、ブローカー選びのコツを毎日1通お届けします。
※ プライバシーは厳守。配信解除はいつでも可能です。